„DDoS“ beschreibt drei sehr verschiedene Vorgänge, die unterschiedliche Antworten brauchen. Wer sie vermischt, kauft Schutz gegen das Problem, das er nicht hat, und steht beim tatsächlichen Vorfall ohne da.
Verfügbarkeit, nicht Vertraulichkeit: Ein Angriff dieser Art stiehlt nichts, er schaltet ab. Für kleine Betriebe ist die realistische Vorbereitung ein Nachmittag und die wichtigste Erkenntnis ist, welchen Teil man gar nicht selbst lösen kann.
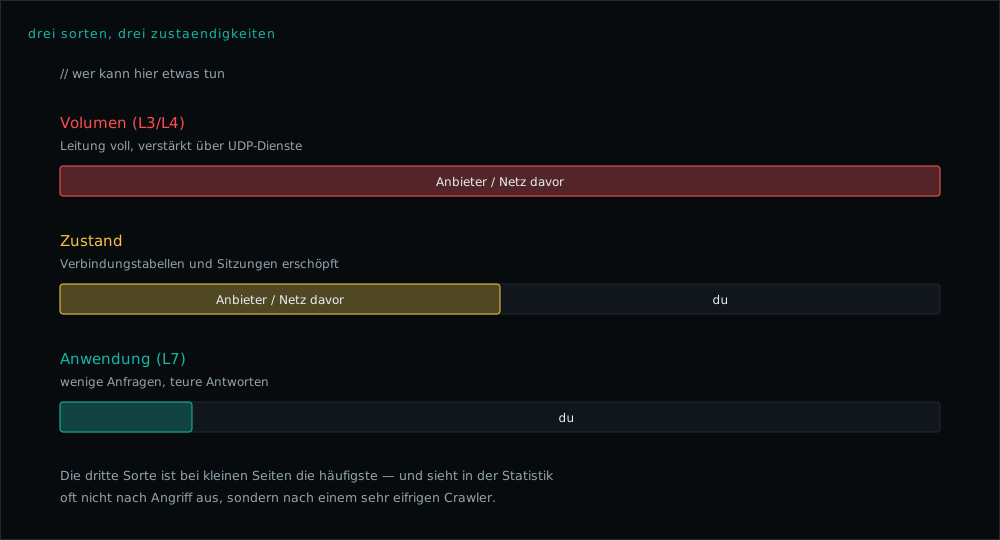
Die drei Sorten#
| Sorte | Was passiert | Wer kann etwas tun |
|---|---|---|
| Volumen (L3/4) | Leitung voll, verstärkt über UDP-Dienste | nur der Anbieter/das Netz davor |
| Zustand | Verbindungstabellen und offene Sitzungen erschöpft | Anbieter und du (Kernelparameter, Grenzen) |
| Anwendung (L7) | wenige Anfragen, teure Antworten (Suche, Export, Login) | überwiegend du |
Die dritte Sorte ist bei kleinen Seiten die häufigste und sie sieht in der Statistik oft gar nicht nach Angriff aus, sondern nach einem sehr eifrigen Crawler.
Was du selbst tun kannst#
Teure Endpunkte begrenzen. Nicht alles gleich behandeln: Suche, Login, Export, Registrierung.
# nginx: getrennte Zonen für teure Pfade
limit_req_zone $binary_remote_addr zone=allgemein:10m rate=20r/s;
limit_req_zone $binary_remote_addr zone=login:10m     rate=1r/s;

server {
  location / {
    limit_req zone=allgemein burst=40 nodelay;
  }
  location /login {
    limit_req zone=login burst=5;
    limit_req_status 429;
  }
  limit_conn_zone $binary_remote_addr zone=verbindungen:10m;
  limit_conn verbindungen 20;
}
Verbindungen begrenzen, bevor sie den Anwendungsprozess erreichen:
# nftables: SYN-Rate je Quelle
nft add rule inet filter input tcp flags syn tcp dport 443 \
  meter syn-fluten { ip saddr limit rate 25/second burst 50 packets } accept
nft add rule inet filter input tcp flags syn tcp dport 443 drop
Nicht selbst zum Verstärker werden. Offene DNS-Auflöser, NTP und Memcached ohne Zugriffsschutz sind der Grund, warum Volumenangriffe funktionieren und sie führen zur Abuse-Meldung im eigenen Postfach. Prüfen: Eingehend dichtmachen.
Statisches statt dynamisch ausliefern. Eine zwischengespeicherte Seite kostet ein Tausendstel dessen, was eine Datenbankabfrage kostet. Der Cache ist die wirksamste Maßnahme gegen Anwendungsfluten, die es gibt.
Ist die Leitung voll, hilft keine Regel auf der Maschine, die Pakete sind bereits über die Leitung gekommen, für die man zahlt. Diese Sorte löst nur, wer davor sitzt: der Anbieter mit Filterung im Netz oder ein vorgelagerter Dienst. Vorher klären, nicht während des Angriffs: Bietet der Hoster Filterung an? Automatisch oder auf Zuruf? Wie erreicht man ihn außerhalb der Geschäftszeiten? Wird die IP im Zweifel nullgeroutet, also abgeschaltet, um andere zu schützen?
Vorgelagerte Dienste: was sie kosten#
Ein Reverse-Proxy-Dienst vor der Seite absorbiert Volumen und filtert Anwendungsfluten. Der Preis ist nicht nur Geld:
- Der Anbieter sieht den entschlüsselten Verkehr. Das ist eine Auftragsverarbeitung und gehört in die Datenschutzdokumentation, oft mit Drittlandsbezug.
- Die echte IP-Adresse muss geheim bleiben, sonst umgeht der Angriff den Schutz einfach. Also: Ursprung nur für die Proxy-Adressen erreichbar machen.
- Fehlersuche wird umständlicher, weil eine Schicht dazwischenliegt.
Für Gameserver gilt zusätzlich, dass UDP-Verkehr anders behandelt wird als HTTP, dort ist die Filterung des Anbieters meist die einzige praktikable Antwort.
Vorbereiten, was im Ernstfall zählt#
- Zugang unabhängig vom Webdienst: Verwaltung über Overlay-Netz, nicht über dieselbe überlastete Schnittstelle.
- Kontaktweg zum Anbieter notiert, inklusive Kundennummer und Rufbereitschaft.
- Messen können, was passiert:
# Wer erzeugt gerade wie viele Verbindungen?
ss -tn state established | awk '{print $4}' | cut -d: -f1 | sort | uniq -c | sort -rn | head

# Welche Pfade werden gerade angefragt?
tail -n 5000 /var/log/nginx/access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head- Eine Notfallseite, statisch, die man vorschalten kann, besser als eine Zeitüberschreitung.
Und die Alarmierung, die auffällt, bevor der erste Kunde anruft: Alarme, die nachts ankommen.
Geschrieben aus dem laufenden Betrieb: MRMedia betreibt eigene Hosts, Kundendienste und deren Härtung in der EU. Eine veraltete Anleitung ist hier ein Sicherheitsproblem, kein Schönheitsfehler. Korrekturen bitte über Discord.