Protokolle beantworten nach einem Vorfall zwei Fragen: Wie kam jemand herein, und was hat er getan. Beide Antworten sind wertlos, wenn die Protokolle auf derselben Maschine liegen, die übernommen wurde, denn wer root hat, kann sie ändern.
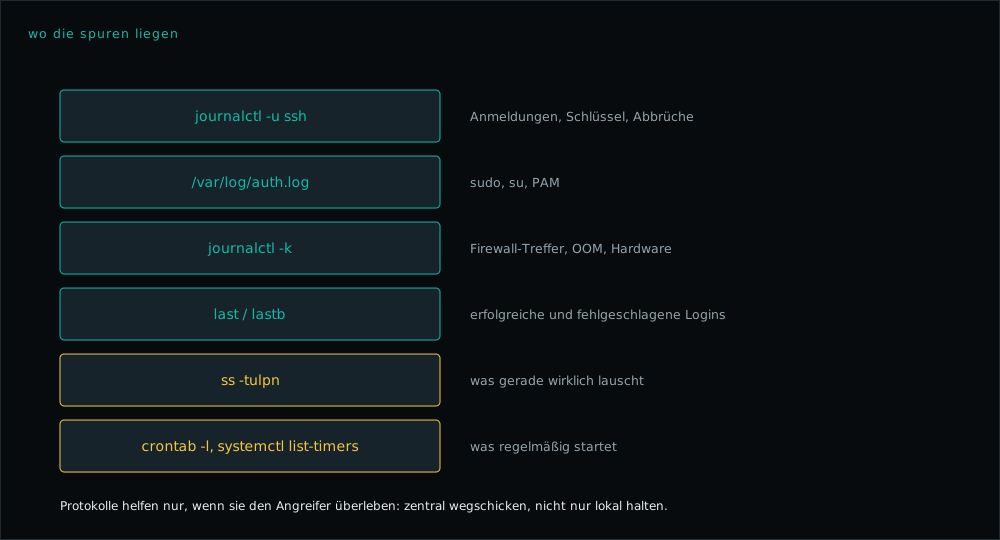
Was wo liegt#
| Quelle | Verrät |
|---|---|
journalctl -u ssh | Anmeldungen, angebotene Schlüssel, Abbrüche |
/var/log/auth.log | sudo, su, PAM-Entscheidungen |
journalctl -k | Firewall-Treffer, OOM-Killer, Hardware |
last, lastb | erfolgreiche und fehlgeschlagene Anmeldungen |
journalctl -u nginx | Anfragen, Fehler, auffällige Muster |
/var/log/unattended-upgrades/ | ob Sicherheitsupdates tatsächlich liefen |
Die letzte Zeile wird gern übersehen und beantwortet die häufigste Frage nach einem Vorfall: War die Lücke zum Zeitpunkt des Einbruchs bereits gepatcht?
Wegschicken, der eigentliche Punkt#
Variante A: journald direkt#
Der einfachste Weg, wenn beide Seiten systemd nutzen.
Auf dem Empfänger:
sudo apt install -y systemd-journal-remote
sudo systemctl enable --now systemd-journal-remote.socket
Auf dem Sender:
sudo apt install -y systemd-journal-remote# /etc/systemd/journal-upload.conf
[Upload]
URL=https://logs.example:19532
ServerKeyFile=/etc/ssl/private/journal-upload.key
ServerCertificateFile=/etc/ssl/certs/journal-upload.crt
TrustedCertificateFile=/etc/ssl/certs/journal-ca.crtsudo systemctl enable --now systemd-journal-upload
sudo systemctl status systemd-journal-uploadVariante B: rsyslog#
Robuster, wenn auch Geräte ohne systemd mitschreiben sollen.
# /etc/rsyslog.d/60-remote.conf auf dem Sender
*.* action(type="omfwd"
           target="logs.example" port="6514" protocol="tcp"
           StreamDriver="gtls" StreamDriverMode="1"
           StreamDriverAuthMode="x509/name"
           StreamDriverPermittedPeers="logs.example"
           queue.type="LinkedList"
           queue.filename="fwd-queue"
           queue.saveOnShutdown="on"
           action.resumeRetryCount="-1")
Die Warteschlangen-Einstellungen sind kein Beiwerk: Ohne sie gehen Einträge verloren, sobald das Ziel kurz nicht erreichbar ist und das ist genau der Moment, in dem etwas passiert.
Zwei Dinge, die häufig fehlen: Der Transport gehört verschlüsselt (TLS), sonst liegen Benutzernamen und Systemdetails im Klartext auf der Leitung. Und das Zielsystem sollte vom Absender aus nicht erreichbar sein außer für den Log-Eingang, sonst räumt ein Angreifer, der die erste Maschine hat, gleich auf dem Logserver hinterher.
Prüfen, dass es ankommt#
# Testeintrag erzeugen
logger -p auth.warning "shieldmyserver-testeintrag $(date +%s)"

# Auf dem Zielsystem suchen
sudo journalctl --directory=/var/log/journal/remote/ --since "5 min ago" | grep testeintrag
Ein Weg, der nie getestet wurde, ist ein Weg mit unbekanntem Zustand. Diese Prüfung gehört einmal im Quartal wiederholt, ein Zertifikatsablauf auf der Empfängerseite bricht die Übertragung still.
Aufbewahrung#
Lokal reicht wenig, zentral braucht es mehr. Der Grund: Vorfälle werden im Mittel Wochen bis Monate nach dem Einbruch entdeckt.
# /etc/systemd/journald.conf — lokal begrenzen
[Journal]
Storage=persistent
SystemMaxUse=500M
MaxRetentionSec=2week
Auf dem Zielsystem eher 90 bis 180 Tage. Was länger aufbewahrt wird, unterliegt der Frage nach dem Zweck, Protokolle enthalten personenbezogene Daten (IP-Adressen, Benutzernamen), und eine unbegrenzte Aufbewahrung ist weder nötig noch zulässig.
Welche Ereignisse einen Alarm auslösen#
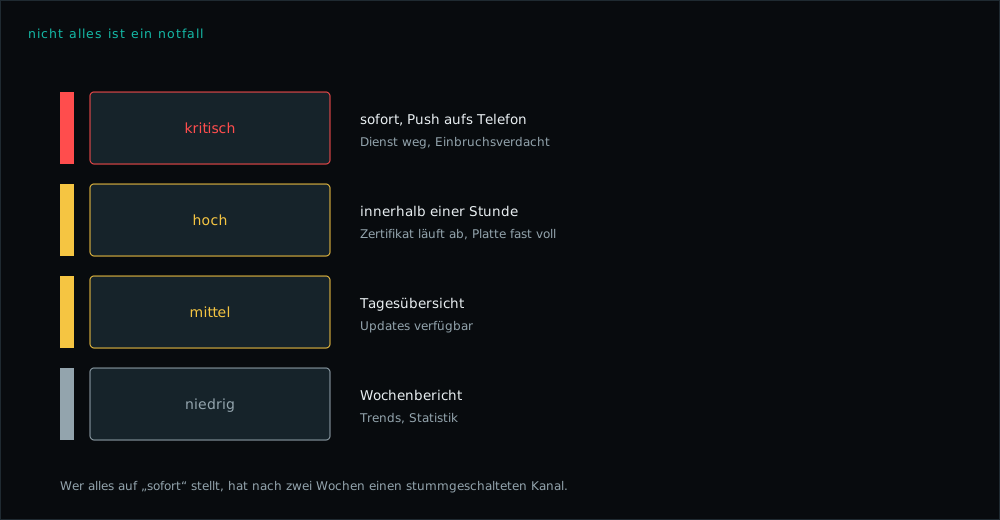
Die kurze Liste dessen, was wirklich weckt:
| Ereignis | Stufe |
|---|---|
| erfolgreiche Anmeldung eines unbekannten Kontos | kritisch |
| neues Konto mit UID 0 | kritisch |
| ausgehende Verbindung auf gesperrtem Port | kritisch |
sudo durch ein Dienstkonto | hoch |
| Sicherheitsupdates seit >48 h ausstehend | hoch |
| Zertifikat läuft in <14 Tagen ab | hoch |
| Neustart ohne geplantes Fenster | mittel |
Und die Liste dessen, was keinen Alarm bekommt, weil es Grundrauschen ist: fehlgeschlagene SSH-Anmeldungen, einzelne 404er, kurze Lastspitzen. Alarmmüdigkeit ist real, nach der dritten belanglosen Nachtmeldung wird auch die vierte weggewischt.
Der Alarmweg braucht selbst eine Überwachung#
Ein Kanal, der stumm bleibt, sieht aus wie ein System ohne Störung. Die Gegenmaßnahme ist ein Dead-Man-Switch: ein Alarm, der auslöst, wenn ein regelmäßiges Lebenszeichen ausbleibt.
# /etc/systemd/system/heartbeat.service
[Unit]
Description=Lebenszeichen an den Statusdienst
[Service]
Type=oneshot
ExecStart=/usr/bin/curl -fsS -m 10 --retry 2 https://status.example/api/push/AbCdEf
# /etc/systemd/system/heartbeat.timer
[Timer]
OnBootSec=2min
OnUnitActiveSec=5min
[Install]
WantedBy=timers.targetDenselben Mechanismus für den nächtlichen Backup-Lauf verwenden, mit Intervall 25 Stunden. Bleibt das Signal aus, ist entweder das Backup nicht gelaufen oder die Maschine weg, beides will man wissen. Der vollständige Monitoring-Aufbau steht auf der Schwesterseite unter Monitoring, das dich auch nachts erreicht.
Was man mit den gesammelten Spuren im Ernstfall anfängt, steht in Einen Einbruch erkennen.
Geschrieben aus dem laufenden Betrieb: MRMedia betreibt eigene Hosts, Kundendienste und deren Härtung in der EU. Eine veraltete Anleitung ist hier ein Sicherheitsproblem, kein Schönheitsfehler. Korrekturen bitte über Discord.